Créditos da imagem: Reveio
Imagina o cenário: você precisa migrar o banco de dados da aplicação em produção, o gestor quer que ninguém perceba nada, e qualquer erro significa sistema fora do ar para milhares de usuários.
Não é exagero. Isso acontece toda semana em times de engenharia pelo mundo.
Este guia mostra como engenheiros experientes conduzem esse processo — sem rezar para dar certo, sem janela de manutenção de 4 horas e sem surpresa no meio da madrugada.
Por Que a Maioria das Migrações Dá Errado
O problema quase nunca é falta de conhecimento técnico. O que derruba as migrações é uma suposição simples e equivocada: que dá para mover os dados de um banco para outro como se fosse renomear uma pasta.
Não dá.
Um banco de dados em produção é um organismo vivo. Enquanto você copia os dados, outras coisas estão acontecendo:
- Escritas chegando em tempo real de múltiplos serviços
- Conexões abertas que não podem ser interrompidas
- Esquemas com dependências que você talvez nem saiba que existem
- Dados sendo alterados exatamente no momento em que são lidos
Ignorar qualquer um desses pontos é receita para inconsistência — ou downtime mesmo.
Publicidade
A Regra Que Muda Tudo: Fases, Não Big Bang
Existe um princípio que separa migrações que funcionam das que viram incidente:
Nunca migre tudo de uma vez.
A abordagem em fases permite que, se algo sair do previsto, você consiga voltar atrás sem perder dados. Engenheiros chamam isso de cutover gradual — e é exatamente o que vamos detalhar aqui.
As 5 Fases de uma Migração Sem Downtime
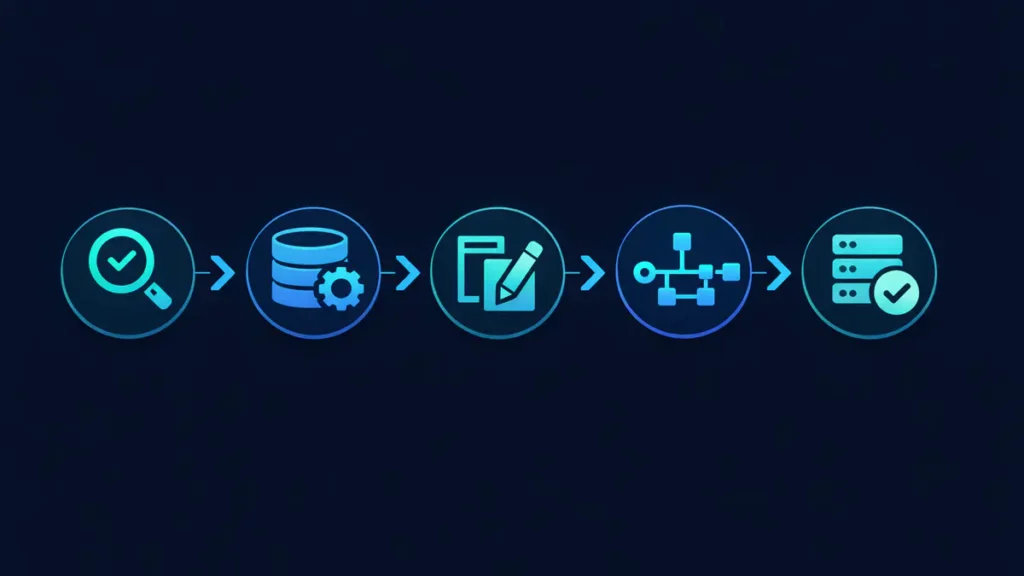
Fase 1 — Entenda o Que Você Tem
Antes de configurar qualquer ferramenta, conheça bem o banco de origem.
- Inventário completo: tabelas, índices, views, stored procedures, triggers
- Volume de dados: tamanho atual e quanto cresce por dia
- Padrões de acesso: quais queries são mais frequentes, onde estão os picos
- Dependências externas: quais sistemas leem e escrevem nesse banco
Ferramentas que ajudam nessa fase: pg_stat_statements no PostgreSQL, sys.dm_exec_query_stats no SQL Server e EXPLAIN ANALYZE para entender as queries mais pesadas.
Ponto importante: registre o SLA atual do banco antes de começar qualquer coisa. Você vai precisar desse número para comparar depois..
Fase 2 — Configure a Replicação em Tempo Real (CDC)
Esse é o coração de uma migração sem downtime. A técnica se chama Change Data Capture, o CDC.
A ideia é simples: em vez de copiar os dados uma vez e rezar, você captura cada alteração que acontece no banco de origem e replica para o destino continuamente.
Na prática, funciona assim:
- Você tira um snapshot inicial dos dados existentes
- O CDC começa a registrar tudo que muda depois desse snapshot
- O banco de destino recebe o snapshot e vai recebendo as mudanças em sequência
- Em algum ponto, os dois bancos ficam sincronizados
Ferramentas para CDC:
- Debezium — open source, funciona com MySQL, PostgreSQL, MongoDB e SQL Server
- AWS Database Migration Service (DMS) — gerenciado, bom para quem já está na AWS
- Google Datastream — CDC nativo do Google Cloud
- Striim — opção empresarial com suporte a muitas fontes diferentes
A ferramenta certa depende da sua infraestrutura, mas o mecanismo é o mesmo em todos os casos.
Fase 3 — Dual-Write: Escreva nos Dois Bancos ao Mesmo Tempo
Aqui fica interessante — e também mais delicado.
Com o CDC sincronizando os dados históricos, o próximo passo é modificar a aplicação para escrever simultaneamente no banco de origem e no banco de destino.
Aplicação → Escreve no Banco A (origem)
→ Escreve no Banco B (destino)
→ Lê do Banco A (por enquanto)
Essa fase serve para três coisas:
- Validar que o destino está recebendo os dados sem erro
- Testar como ele se comporta com carga real
- Descobrir problemas de tipo de dado ou estrutura de schema antes que virem incidente
Um detalhe que não pode ser ignorado: o dual-write aumenta a latência nas escritas. Configure timeouts assimétricos — se o banco de destino falhar por qualquer motivo, isso não pode bloquear a escrita no banco de origem.de escrita. Configure timeouts assimétricos — se o banco de destino falhar, a escrita no banco de origem não pode ser bloqueada.
Fase 4 — Migre as Leituras aos Poucos
Com os dois bancos sincronizados e o dual-write rodando estável, começa a transição real.
Mas sem virar a chave de uma vez. Use feature flags ou roteamento por percentual de tráfego para ir migrando as leituras em etapas:
- 5% das leituras indo para o Banco B
- 20% das leituras indo para o Banco B
- 50% das leituras indo para o Banco B
- 100% das leituras indo para o Banco B
A cada etapa, compare os resultados entre os dois bancos. Se uma query devolver dados diferentes dependendo de qual banco responde, você achou um bug antes que ele chegasse aos usuários.
Ferramentas para fazer esse roteamento:
- LaunchDarkly — feature flags com controle granular de rollout
- NGINX ou Envoy — roteamento percentual no nível de proxy
- AWS Route 53 Weighted Routing — para arquiteturas na AWS
Fase 5 — Cutover Final
Quando 100% das leituras já estão no banco de destino e o dual-write ficou estável por pelo menos 48 a 72 horas, você está pronto para o cutover.
Checklist antes de virar a chave:
- (✔️)Não seleciona nada Backup completo do banco de origem confirmado
- (✔️)Não seleciona nada Lag de replicação abaixo de 1 segundo
- (✔️)Não seleciona nada Monitoramento ativo no banco de destino
- (✔️)Não seleciona nada Plano de rollback documentao e testado de verdade
- (✔️)Não seleciona nada Time avisando e com canal de comunicação aberto
No cutover em si: você para o dual-write, drena o que ainda está na fila do CDC e redireciona 100% do tráfego para o novo banco.
Não desative o banco de origem imediatamente. Deixe ele em modo read-only por alguns dias — é seu plano B caso algo apareça depois.modo read-only por alguns dias antes de ser descomissionado — é o seu safety net.
Publicidade
Estratégias para Cada Tipo de Migração
MySQL → PostgreSQL
A maior dificuldade aqui é a diferença nos tipos de dados e no comportamento das transações.
- Use o pgloader para migrar o schema e os dados históricos
- Preste atenção na diferença entre AUTO_INCREMENT e SERIAL/SEQUENCE
- Revise queries com GROUP BY — o PostgreSQL é mais rigoroso que o MySQL nesse ponto
MongoDB → PostgreSQL (ou outro relacional)
Passar de NoSQL para SQL exige planejamento de desnormalização. Os dados precisam ser reorganizados antes de chegar no destino.
- Mapeie documentos aninhados para tabelas relacionadas
- Campos dinâmicos podem virar colunas JSONB no PostgreSQL sem perder flexibilidade
- O Debezium tem um conector específico para MongoDB que facilita bastante o CDC
On-Premise → Cloud (RDS, Cloud SQL, AlloyDB)
Nesse cenário, o CDC é ainda mais crítico porque a latência de rede é uma variável nova que você não tinha antes.
- Teste a janela de replicação com carga real antes de planejar o cutover
- Configure VPN ou Direct Connect/Interconnect para a fase de migração
- Valide compliance e criptografia em repouso antes de mover qualquer dado sensível
O Que Monitorar Durante Todo o Processo
Sem visibilidade, qualquer problema vira surpresa. Você precisa acompanhar algumas métricas em tempo real:
- Lag de replicação — idealmente abaixo de alguns segundos em produção
- Taxa de erros de escrita — qualquer pico indica problema no dual-write
- Latência de queries — compare P50, P95 e P99 entre os dois bancos
- Consumo de CPU, memória e disco no banco de destino sob carga real
Uma stack de monitoramento que funciona bem nesse contexto:
- Prometheus + Grafana — dashboards em tempo real com alertas configuráveis
- pgBadger (para PostgreSQL) — análise detalhada dos logs de queries
- Datadog ou New Relic — observabilidade completa com alertas automáticos
Erros que Aparecem Mais do que Deveriam
Subestimar a fila do CDC O CDC acumula eventos. Se o banco de destino começar a travar, a fila cresce. Se não monitorar, você descobre tarde demais.
Ignorar constraints e triggers no destino Constraints que não existiam na origem podem rejeitar dados durante a migração. A solução é desabilitar temporariamente e reabilitar só após validação completa.
Não testar o rollback de verdade Documentar o processo de rollback não é suficiente. Precisa executar em staging. Se você nunca rodou o rollback, ele vai falhar exatamente quando você mais precisar.
Fazer cutover em horário de pico Parece óbvio, mas continua sendo um dos erros mais comuns. Sem exceção: prefira janelas de baixo tráfego.
Publicidade
Vale a Pena Usar um Banco Gerenciado na Nuvem?
Provedores como AWS RDS, Google Cloud SQL, Azure Database, PlanetScale e Neon trazem recursos que mudam bastante o trabalho de migração:
- Replicação gerenciada com failover automático
- Backups point-in-time com restauração granular
- Monitoramento integrado com alertas já configurados
- Escalabilidade vertical sem downtime em várias plataformas
Além disso, migrar para um banco gerenciado na nuvem costuma ser o momento mais natural para atualizar a versão do banco de dados — você já vai testar tudo do zero mesmo..
O Protocolo em Resumo
Se você precisar guardar só o essencial deste guia:
Deixe o banco de origem em read-only por 72h antes de descomissionarprocesso não está torcendo para dar certo. Está executando um plano que já foi validado cada passo.
Audite o banco de origem antes de qualquer coisa
Configure o CDC como primeiro passo técnico
Ative o dual-write e valide continuamente
Migre as leituras em percentuais, usando feature flags
Faça o cutover final só com lag abaixo de 1s e backup confirmado
Migração sem downtime não é questão de sorte ou de ter uma equipe grande. É protocolo bem executado.
Quem segue esse processo não fica esperando o melhor. Já testou cada passo antes de precisar confiar neles.
Com informações de Napoleon.